前言 化工 B2B 和普通电商有明显区别,很多同行的方案是关键词搜供应商,再二次遍历;本文思路反过来:传入店铺标识,直接归集该供应商名下全部上架产品,重点解决化工品类特有的 CAS 号缺失、供应有效期混杂、报价格式不统一、分页参数动态变化等问题,适合做供应商物料台账、竞品物料盘点、定期供货巡检场景。化工商品核心价值字段不是规格,而是 CAS 编码、包装、供货周期,这也是本次代码优先保留的字段。 整个封装分为三层:请求层、解析层、分页控制层。请求层固定携带厂商 ID,避免跨店铺串数据;解析层优先提取 CAS 号,CAS 为空时单独标记,方便后续过滤无效物料;分页采用 “空数据终止” 策略,不依赖总页数,适配平台后端分页参数不定期调整的情况。 化工报价经常出现 “面议、电询”,代码不做强制数值转换,保留原始文本,避免业务信息丢失。同时增加请求间隔,降低访问频率,保障稳定返回。 店铺标识不是店铺名称,是主页链接里的 companyId,名称无法直接用于检索; 很多老供应信息存在过期时间,业务使用时建议增加 valid_date 过滤; 部分产品无 CAS 号,属于普通化工辅料,需要单独做标签区分; 平台会校验请求头,缺少 Referer 容易返回空数据。 这套方案聚焦单供应商物料归集,区别于关键词检索供应商的常规思路,更适合供应链人员定点跟踪某一家工厂的上新、调价、下架变化。输出结果可以直接入库,用于长期供应商物料监控。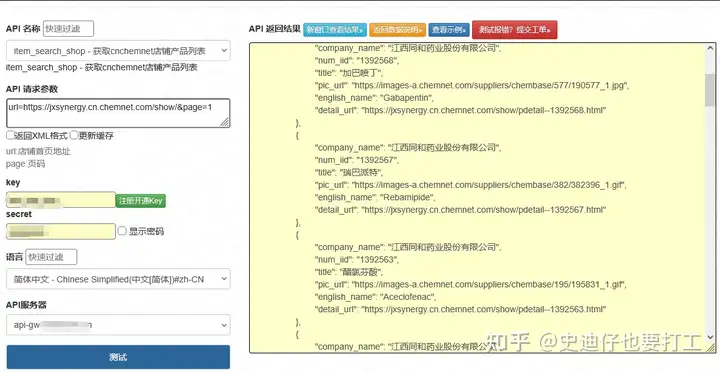
点击获取key和secret
代码实现
import requests
import time

class ChemNetShopProduct:
    def __init__(self, shop_id, timeout=10):
        self.shop_id = shop_id
        self.timeout = timeout
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "Accept": "application/json, text/plain, */*",
            "Referer": "https://cn.chemnet.com/"
        }
        self.result_list = []

    def get_page_data(self, page):
        params = {
            "companyId": self.shop_id,
            "page": page,
            "size": 20
        }
        try:
            resp = requests.get("https://cn.chemnet.com/company/product/list",
                                params=params, headers=self.headers, timeout=self.timeout)
            if resp.status_code != 200:
                return None
            return resp.json()
        except Exception as e:
            print(f"请求异常:{str(e)}")
            return None

    def parse_item(self, item):
        return {
            "product_name": item.get("productName"),
            "cas_no": item.get("casNo"),
            "price_info": item.get("price"),
            "pack": item.get("pack"),
            "valid_date": item.get("validDate"),
            "product_url": item.get("link"),
            "img": item.get("imgUrl"),
            "source_shop": self.shop_id
        }

    def run(self):
        page = 1
        while True:
            data = self.get_page_data(page)
            if not data or data.get("data") is None or len(data["data"]) == 0:
                break
            for row in data["data"]:
                self.result_list.append(self.parse_item(row))
            page += 1
            time.sleep(1.2)
        return self.result_list

if __name__ == "__main__":
    # 替换为目标店铺companyId
    spider = ChemNetShopProduct(shop_id="123456")
    res = spider.run()
    print(f"共获取产品数量:{len(res)}")
    for p in res[:5]:
        print(p)
核心逻辑解读
落地踩坑总结
总结